外观主题
治好 Antigravity CLI 深思考模型“闷头调工具零开口”:Prompt 先验 + 轻量 PreInvocation 防静默双层方案
本文档介绍一套面向 Antigravity CLI(agy)的极简双层防静默方案(~/.gemini/config/GEMINI.md + ~/.gemini/config/hooks/silent_turn_nudge.py),专门用于解决深度推理模型(尤其是 Hydrogen XHigh 等高思考预算档位)在连续工具调用期间长期“零正文输出、闷头干活”导致交互像卡死一样的体验痛点。
整套方案零外部依赖,核心 Hook 脚本仅 187 行纯标准库 Python,在 23.43 MB / 10,385 步超长日志上纯判定耗时 0.10 ms,跨 /compact 与 压缩后无损回水方案 天然零残留;经 45 个真实会话、296 次生产级触发 验证,次轮立即开口唤醒率达 94.9%,其中 89.0% 做到了开口同时继续调用工具(零额外废回合)。
1. 背景与单一变量实测:为什么模型越“会想”,体感反而越像“卡死”?
在终端 Agent 场景下,高思考预算模型(如 Hydrogen XHigh)能连续规划几十步排查、编译和 UI 测试,但伴随出现一个非常影响日常协作的现象:终端长时间停留在转圈状态,界面上没有任何中文进展说明,用户根本分不清它是在正常跑编译/测试,还是已经陷入死循环或卡死。
为了确认这是不是偶然波动,我们在一条真实运行的 6,400+ 步长对话 中保持上下文、项目与全局规范完全一致,做了一次单一变量模型热切对照:
| 对照分组(同一 6,400+ 步长对话) | 模型档位 | 观测范围 | 边调工具边汇报占比 | 最长连续静默表现 |
|---|---|---|---|---|
| 基线组 | Carbon High | 66 次模型回复 | 28.8% | 常规间隔即会输出阶段进展 |
| 热切对照组 | Hydrogen XHigh | UI 测试与编译长链 | 0.0% | 连续 74 步、20 次工具调用全程 0 开口,直到全部跑完才一口气吐出最终总结 |
将这条主会话继续追踪至 10,385 步 后,我们在上线防静默 Hook 前的 Hydrogen XHigh 完整窗口(steps 6345..6688)中观测到更极端的黑盒静默:99 次模型回复里边调工具边开口仅有 4 次(4.0%,仅占工具轮次的 4.7%),最长一段连续静默达到 37 轮工具调用(累计 102 次工具、跨越 138 步、持续 538 秒 / 近 9 分钟全程零文字输出)。
2. 根因拆解:为什么单靠写一句“请汇报进度”救不了深思考模型?
单纯在系统提示词里写“请多汇报进度”,在深思考模型上往往很快失效,甚至引入副作用。拆解日志后可以看到三个底层原因:
- 双通道可见性错觉(Internal Thinking ≠ User-Visible Output) 深度推理模型在调用工具前,通常会先在隐藏的
thinking通道里写下几百字的排查思路、假设与下一步计划。在模型自己的认知视角里,它“已经把计划交代得很清楚了”,于是正文content留空、直接发出tool_calls。但终端用户默认看不到内部思考和原始工具输出,只能看到PLANNER_RESPONSE.content,导致**“模型以为自己说了,用户以为它哑了”**。 - 长工具链下的指令注意力衰减(Recency Decay) 全局提示词位于上下文最顶部。一旦进入连续十几轮高密度的
tool_call ↔ tool_result闭环,每一轮大量的思考 Token 与工具输出都会不断稀释顶部风格规范的注意力权重——这正是同上下文下Hydrogen XHigh工具轮次开口率跌至4.7%的直接原因。 - 朴素催促带来的两种反作用陷阱
- 陷阱 A(过度刷屏):不区分任务复杂度,导致查个 1~2 步的简单命令也先写一段开场白,拉低信息密度;
- 陷阱 B(“只说不做”断流):模型为了响应催促,单独输出一句“接下来我去查配置文件”却不附带任何
tool_calls,直接提前结束当前 Agent 循环,反逼用户手动再敲一次“继续”。
3. 两层极简架构:Prompt 管开场分流,Hook 做兜底熔断
基于上述根因,我们把“开口时机”和“长链保活”拆成正交的两层——不叠加冗长规则,也不引入任何外部 LLM 调用:
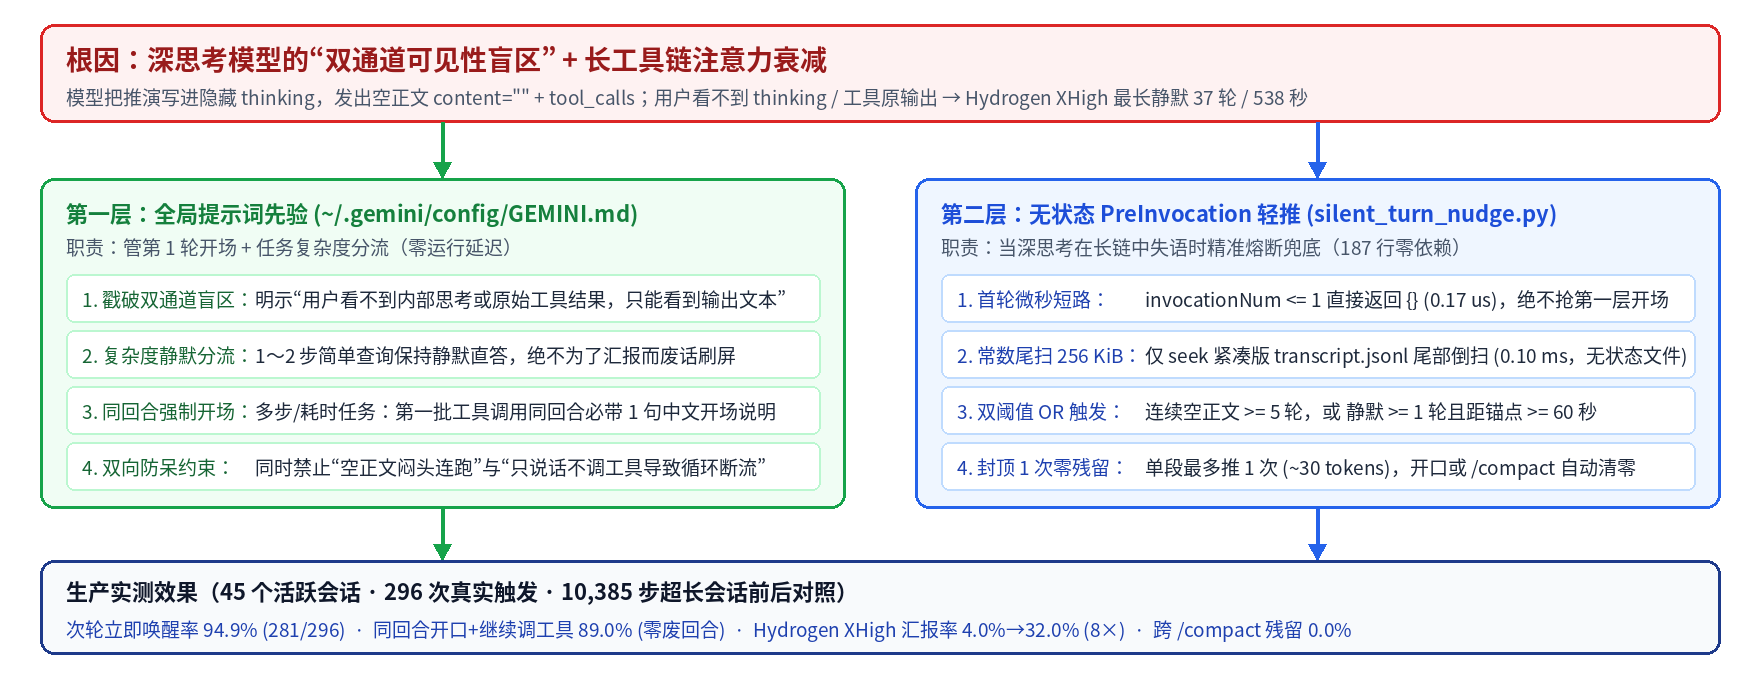
3.1 第一层:全局提示词先验(~/.gemini/config/GEMINI.md)
第一层负责第 1 轮开场和简单/复杂任务分流,零运行时延迟。核心只有三点精准措辞:
- 直接戳破双通道盲区:开篇第一句写明*“用户看不到你的内部思考或原始工具结果,只能看到你输出的文本”*,把“在
thinking里想过”与“对用户可见”彻底拆开; - 明确 1~2 步静默边界:简单问答或 1~2 步即可结束的只读查询保持静默直答,避免高频刷屏;
- 锁死同回合开场 + 禁只说不做:要求多步排查、修改或执行耗时命令时,“第一批工具调用同回合必须先附带 1 句中文开场说明准备查/做什么(勿只说不做或空正文闷头连跑)”,同时要求后续关键节点用 1~2 句中文简报已确认事实与下一步。
3.2 第二层:无状态 PreInvocation 防静默轻推(silent_turn_nudge.py)
当深思考模型在长链中发生注意力衰减、忘记第一层规范时,第二层 PreInvocation Hook 会以极低成本介入兜底。整套状态机完全无状态(不写任何外部 sidecar 状态文件,transcript.jsonl 本身就是唯一真相源):
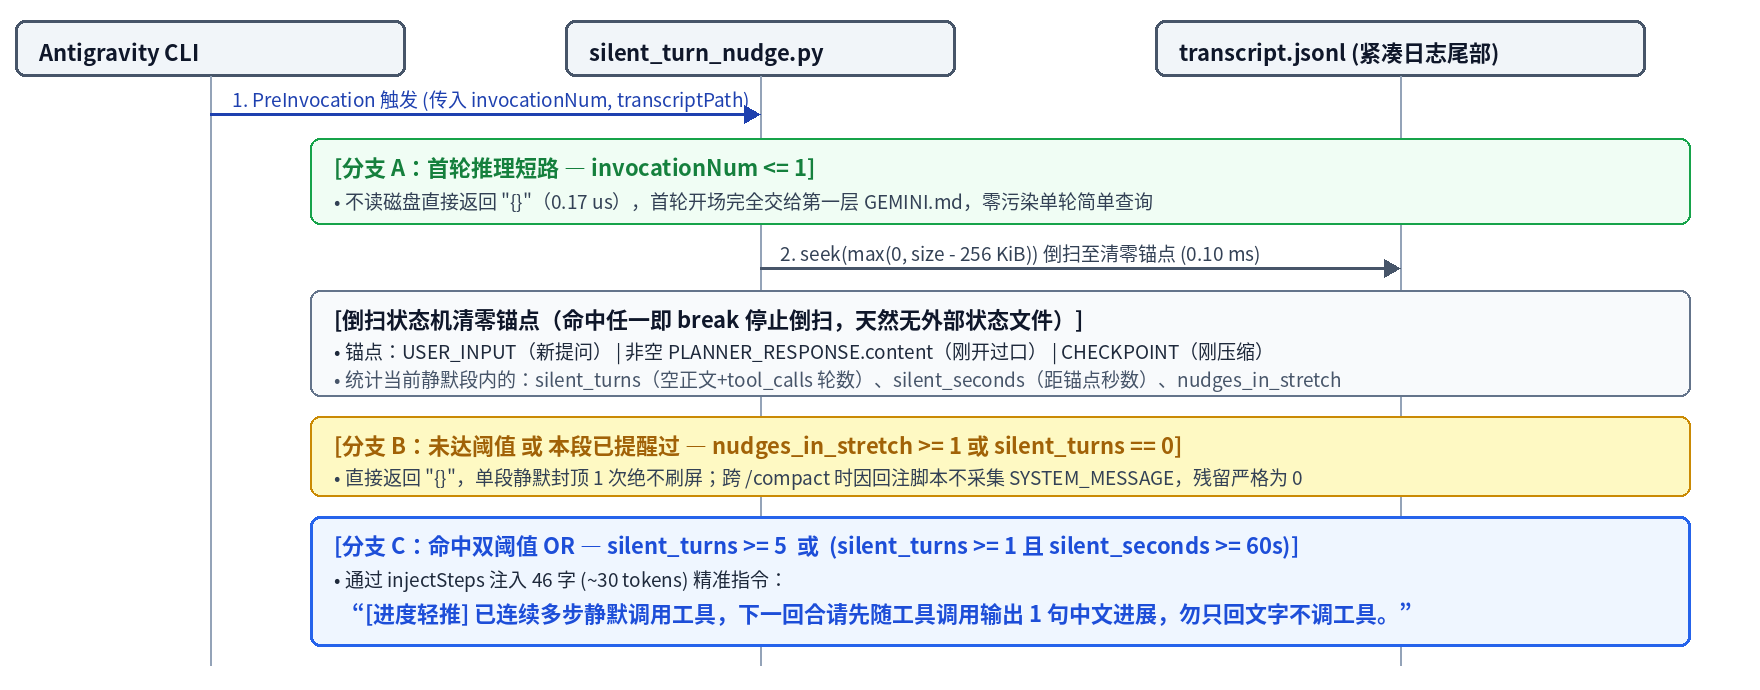
脚本内的 5 个关键工程细节:
- 首轮零开销短路(
invocationNum <= 1):每轮用户提问后的第 1 次推理直接跳过返回{},既不抢第一层提示词的活,也不干扰单轮简单问答。 - 常数级 I/O 尾扫紧凑日志(
TAIL_READ_BYTES = 262_144):刻意读取紧凑版transcript.jsonl(长工具输出已截断)而非动辄几十 MB 的transcript_full.jsonl,无论会话跑了 10 步还是10,385步,都只seek末尾256 KiB并丢弃可能被拦腰切开的首行半截 JSON,随后倒序扫描直到命中以下任一清零锚点:USER_INPUT(用户发起了新一轮对话);PLANNER_RESPONSE且content.strip()非空(模型刚刚向用户开过口);CHECKPOINT(刚刚发生过上下文压缩)。
- 双阈值 OR 触发(同时拦住“高频连扫”与“单步慢命令”):
- 轮次阈值:连续空正文调工具
silent_turns >= 5(默认AGY_SILENT_NUDGE_TURNS=5),防止高频连读十几个文件不吭声; - 时长阈值:静默调工具
silent_turns >= 1且距锚点(用户发言/上次开口/压缩点)已满60秒(默认AGY_SILENT_NUDGE_SECONDS=60),防止单条耗时编译或 UI 测试跑了一两分钟回来后继续哑着往下跑。
- 轮次阈值:连续空正文调工具
- 单段封顶 1 次 + 防断流精准文案:
- 倒扫期间同步计数当前静默段内已出现的
MARKER = "[进度轻推]",达到AGY_SILENT_NUDGE_MAX=1立即break并返回{},绝不在同一段静默里反复轰炸上下文; - 注入正文严格压缩至 46 字(
122字节,约30tokens),且末尾显式防“只说不做”:[进度轻推] 已连续多步静默调用工具,下一回合请先随工具调用输出 1 句中文进展,勿只回文字不调工具。
- 倒扫期间同步计数当前静默段内已出现的
- 与
/compact无损回水方案天然正交、跨压缩零残留:- 本脚本倒扫遇到
CHECKPOINT自动归零; - 配套的
rehydrate_after_compact.py在重建历史时只采集USER_INPUT与PLANNER_RESPONSE,不收集任何SYSTEM_MESSAGE。因此压缩一旦发生,所有历史[进度轻推]都会被彻底清理出上下文,不会跨压缩周期滚雪球累积。
- 本脚本倒扫遇到
4. 真机生产验收数据(10,385 步前后消融 + 45 会话 / 296 次触发统计)
将两层方案同步部署到主力开发机后,我们对真实生产会话日志进行了全量离线回溯统计(无人工挑样本)。
4.1 同一超长会话(10,385 步)上线前后对比
在同一条主会话的连续时间线上(step 6689 首次启用防静默 Hook),对比同一模型在上线前后的行为变化:
观测阶段(同一 10,385 步主会话) | 模型档位 | 回复总数 | 边调工具边开口(占全部回复 / 占工具轮次) | >=10 轮静默次数 | 最长连续静默(轮数 / 工具数 / 时长) |
|---|---|---|---|---|---|
上线前(steps 6345..6688) | Hydrogen XHigh | 99 | 4(4.0% / 4.7%) | 1 | 37 轮 / 102 工具 / 538 s |
上线后(steps 6689..7152) | Hydrogen XHigh | 125 | 40(32.0% / 38.5%,8.0×) | 0 | 6 轮 / 20 工具 / 75 s |
上线前(steps 5406..6344) | Carbon High | 303 | 145(47.9% / 57.3%) | 3 | 12 轮 / 31 工具 / 388 s |
上线后(steps 7153..10259) | Carbon High | 921 | 631(68.5% / 77.8%) | 0 | 5 轮 / 12 工具 / 97 s |
上线后(steps 10260..10385) | Neon High | 40 | 35(87.5% / 97.2%) | 0 | 1 轮 / 2 工具 / 0 s |
关键发现:
- 在最容易“哑火”的
Hydrogen XHigh上,边调工具边汇报比例从4.0%跃升至32.0%(提升 8 倍),原本长达 9 分钟(538 秒 / 37 轮) 的黑盒静默被直接压回75秒 /6轮 以内; - 在
Carbon High超过 3,100 步、1,689 次工具调用的长周期运行里,>=10轮静默彻底清零,最长静默轮数精确封顶在阈值5轮。
4.2 全机 45 个真实会话、296 次生产触发唤醒率统计
| 生产指标(45 个活跃会话全量扫描) | 实测结果 | 占比 / 说明 |
|---|---|---|
[进度轻推] 累计触发次数 | 296 次 | 覆盖 45 个不同工作区与任务类型 |
| 次轮立即开口唤醒次数 | 281 / 296 | 94.9%(收到轻推后的紧邻下一轮即输出可见文本) |
| 其中:同回合“开口 + 继续调工具” | 250 / 281 | 占开口回复的 89.0%(占全部触发 84.5%,零废回合) |
| 其中:纯文字回复(收尾总结 / 向用户请示) | 31 / 281 | 11.0% |
| 2 轮内开口唤醒次数 | 284 / 296 | 95.9% |
| 次轮仍保持静默次数 | 10 / 296 | 3.4%(其余 5 次在次轮前被用户新消息打断) |
经 /compact 回注泄漏的 SYSTEM_MESSAGE | 0 / 296 | 0.0%(零跨压缩残留) |
4.3 运行时延迟与 Token 开销压测
在 23.43 MB、10,385 步的真实 transcript.jsonl 上连续基准测试:
| 测量项 | 实测耗时 / 体积 | 说明 |
|---|---|---|
invocationNum <= 1 快路径(函数级) | 0.17 μs | 不打开日志文件,直接返回 {} |
invocationNum >= 2 尾扫 256 KiB(函数级) | 0.10 ms | 与文件总大小无关,恒定 $O(1)$ 字节读取 |
| 含 Python 进程启动的端到端耗时(20 次均值) | 18.75 ms | 远低于单次模型首字延迟(秒级),体感无感 |
| 单次轻推注入体积 | 46 字符 / 122 B(~30 tokens) | 同一静默段最多注入 1 次 |
5. 诚实的边界与设计取舍
为了避免过度承诺,以下三处边界需要提前明确:
PreInvocation发生在“下一轮模型推理前”,无法中断正在执行中的单条命令 如果模型在第 1 轮静默发起了耗时 5 分钟的run_command,Hook 只能等该命令执行完毕、准备进入第 2 轮推理前才触发轻推。这正是为什么必须保留第一层GEMINI.md,在源头要求“第一批工具同回合必须先附带 1 句中文开场”。两层是互补关系,缺一不可。- 单段封顶 1 次(
DEFAULT_MAX_NUDGES = 1)的克制取舍 实测有约3.4%的极少数情况下,模型收到 1 次轻推后次轮仍未开口。我们刻意选择不反复连推,避免在模型专注排障时往上下文塞入多条重复系统提示干扰注意力;如希望更激进,可通过环境变量AGY_SILENT_NUDGE_MAX=2调整。 - 严格 Fail-Open 容错 脚本内所有文件 IO、JSON 解析与时间转换均包在顶层异常保护内,任何异常都静默返回
{}并以exit 0放行,绝不阻塞 CLI 正常推理。
6. 一键部署指南
6.1 第一步:在 ~/.gemini/config/GEMINI.md 加入进度更新规范
将以下段落写入全局 ~/.gemini/config/GEMINI.md(已存在其它个人规则时直接追加即可):
markdown
# 过程性进度更新规范

用户看不到你的内部思考或原始工具结果,只能看到你输出的文本。简单问答或 1~2 步可结束的简单查询保持静默直答;凡需多步排查、修改或执行耗时命令,**第一批工具调用同回合必须先附带 1 句中文开场说明准备查/做什么**(勿只说不做或空正文闷头连跑),并在后续关键节点提供简短进度更新,不要只在结束后汇报。

## 更新时机
- 开始新的排查、实现或修改工作时。
- 完成关键步骤,或获得重要发现时。
- 遇到错误、阻塞、风险,或需要调整方案时。
- 开始预计耗时较长的操作前。
- 需要用户补充信息或作出决策时,立即说明。

## 更新内容
- 每条更新用 1~2 句中文,简要说明已完成的工作、关键结果和下一步。任务刚开始时,说明即将开展的工作;尚无结果时,不必强行补齐。
  例如:“已找到配置文件,缓存路径可能存在问题。接下来会核对实际读取的配置,并验证修改是否生效。”

## 更新要求
- 只报告可验证的操作和结果,明确区分已确认事实与待验证判断。
- 不输出详细思维链,不编造进度。
- 合并琐碎步骤,避免逐条复述工具输出或频繁刷屏。
- 遇到阻塞或风险时,说明影响及所需协助;需要用户决策时,给出明确问题。
- 多步任务结束后,简要汇总结果、验证情况和遗留事项。
6.2 第二步:放置脚本并合入 ~/.gemini/config/hooks.json
- 直接下载 silent_turn_nudge.py(或复制附录全文)保存至
~/.gemini/config/hooks/silent_turn_nudge.py并赋予执行权限:
bash
mkdir -p ~/.gemini/config/hooks
chmod +x ~/.gemini/config/hooks/silent_turn_nudge.py- 在
~/.gemini/config/hooks.json中注册silent-turn-nudge(如同时使用 压缩后无损回水方案 或其他自定义 Hook,直接并列合入顶层对象,不要覆盖原有条目):
json
{
  "post-compact-rehydrate": {
    "enabled": true,
    "PreInvocation": [
      {
        "type": "command",
        "command": "/usr/bin/python3 ~/.gemini/config/hooks/rehydrate_after_compact.py",
        "timeout": 10
      }
    ]
  },
  "silent-turn-nudge": {
    "enabled": true,
    "PreInvocation": [
      {
        "type": "command",
        "command": "/usr/bin/python3 ~/.gemini/config/hooks/silent_turn_nudge.py",
        "timeout": 5
      }
    ]
  }
}
6.3 可选环境变量调优与一键自查
无需修改源码,可通过环境变量覆盖默认阈值:
| 环境变量 | 默认值 | 含义 |
|---|---|---|
AGY_SILENT_NUDGE_TURNS | 5 | 连续空正文调用工具达到几轮触发轻推 |
AGY_SILENT_NUDGE_SECONDS | 60 | 至少静默 1 轮且距上次锚点满多少秒触发轻推 |
AGY_SILENT_NUDGE_MAX | 1 | 同一段静默内最多注入几次轻推 |
运行一段时间后,可用一行只读命令核查本机全部会话的真实触发次数:
bash
python3 -c 'from pathlib import Path; hits=[sum("[进度轻推]" in l for l in open(p, errors="replace")) for p in (Path.home()/".gemini/antigravity-cli/brain").glob("*/.system_generated/logs/transcript.jsonl")]; print("sessions:", sum(h>0 for h in hits), "total_nudges:", sum(hits))'7. 附录:完整源码(silent_turn_nudge.py,187 行零依赖标准库)
python
#!/usr/bin/env python3
"""Antigravity PreInvocation hook: lightweight anti-silence nudge for long tool chains."""

from __future__ import annotations

from datetime import datetime
import json
import os
from pathlib import Path
import sys
from typing import Any

MARKER = "[进度轻推]"
NUDGE_TEXT = (
    "[进度轻推] 已连续多步静默调用工具,"
    "下一回合请先随工具调用输出 1 句中文进展,勿只回文字不调工具。"
)

DEFAULT_TURN_THRESHOLD = 5
DEFAULT_SECONDS_THRESHOLD = 60
DEFAULT_MAX_NUDGES = 1
TAIL_READ_BYTES = 262_144


def _env_int(name: str, default: int, minimum: int = 1) -> int:
    raw = os.environ.get(name)
    if raw is None or not raw.strip():
        return default
    try:
        return max(minimum, int(raw))
    except ValueError:
        return default


def parse_iso_epoch(ts_str: Any) -> float | None:
    if not isinstance(ts_str, str) or not ts_str:
        return None
    try:
        norm = ts_str[:-1] + "+00:00" if ts_str.endswith("Z") else ts_str
        return datetime.fromisoformat(norm).timestamp()
    except ValueError:
        return None


def resolve_transcript_path(payload: dict[str, Any]) -> Path | None:
    tp = payload.get("transcriptPath")
    if isinstance(tp, str) and tp:
        p = Path(tp)
        if p.is_file():
            return p
    cid = payload.get("conversationId")
    if isinstance(cid, str) and cid:
        p = (
            Path.home()
            / ".gemini"
            / "antigravity-cli"
            / "brain"
            / cid
            / ".system_generated"
            / "logs"
            / "transcript.jsonl"
        )
        if p.is_file():
            return p
    return None


def read_tail_lines(path: Path, max_bytes: int = TAIL_READ_BYTES) -> list[bytes]:
    size = path.stat().st_size
    if size <= 0:
        return []
    with open(path, "rb") as fb:
        seek_pos = max(0, size - max_bytes)
        fb.seek(seek_pos)
        chunk = fb.read()
    lines = chunk.splitlines()
    if seek_pos > 0 and lines:
        lines = lines[1:]
    return lines


def analyze_silence(
    lines: list[bytes],
    now_epoch: float,
    max_nudges: int = DEFAULT_MAX_NUDGES,
) -> tuple[int, float | None, int]:
    """Scan backward to the latest user turn, spoken planner reply, or checkpoint."""
    silent_turns = 0
    nudges_in_stretch = 0
    anchor_epoch: float | None = None
    oldest_epoch: float | None = None

    for raw in reversed(lines):
        if not raw.strip():
            continue
        try:
            obj = json.loads(raw.decode("utf-8", "replace"))
        except json.JSONDecodeError:
            continue

        ts = parse_iso_epoch(obj.get("created_at"))
        if ts is not None:
            oldest_epoch = ts

        stype = obj.get("type")
        if stype == "USER_INPUT":
            if anchor_epoch is None:
                anchor_epoch = ts
            break
        if stype == "CHECKPOINT":
            if anchor_epoch is None:
                anchor_epoch = ts
            break
        if stype == "SYSTEM_MESSAGE":
            if MARKER in str(obj.get("content") or ""):
                nudges_in_stretch += 1
                if anchor_epoch is None:
                    anchor_epoch = ts
                if nudges_in_stretch >= max_nudges:
                    break
            continue
        if stype == "PLANNER_RESPONSE":
            content = str(obj.get("content") or "").strip()
            if content:
                if anchor_epoch is None:
                    anchor_epoch = ts
                break
            if obj.get("tool_calls"):
                silent_turns += 1

    ref_epoch = anchor_epoch if anchor_epoch is not None else oldest_epoch
    silent_seconds = max(0.0, now_epoch - ref_epoch) if ref_epoch is not None else None
    return silent_turns, silent_seconds, nudges_in_stretch


def should_nudge(payload: dict[str, Any], now_epoch: float | None = None) -> bool:
    inv_num = payload.get("invocationNum")
    if isinstance(inv_num, int) and inv_num <= 1:
        return False

    tpath = resolve_transcript_path(payload)
    if tpath is None:
        return False

    turn_threshold = _env_int("AGY_SILENT_NUDGE_TURNS", DEFAULT_TURN_THRESHOLD)
    sec_threshold = _env_int("AGY_SILENT_NUDGE_SECONDS", DEFAULT_SECONDS_THRESHOLD)
    max_nudges = _env_int("AGY_SILENT_NUDGE_MAX", DEFAULT_MAX_NUDGES)

    lines = read_tail_lines(tpath)
    if not lines:
        return False

    now = datetime.now().timestamp() if now_epoch is None else now_epoch
    silent_turns, silent_seconds, nudges_in_stretch = analyze_silence(
        lines, now, max_nudges=max_nudges
    )
    if nudges_in_stretch >= max_nudges or silent_turns <= 0:
        return False
    if silent_turns >= turn_threshold:
        return True
    if silent_seconds is not None and silent_seconds >= sec_threshold:
        return True
    return False


def main() -> None:
    try:
        raw_in = sys.stdin.read()
        if not raw_in.strip():
            print("{}")
            return
        payload = json.loads(raw_in)
        if not isinstance(payload, dict) or not should_nudge(payload):
            print("{}")
            return
        print(
            json.dumps(
                {"injectSteps": [{"systemMessage": {"systemMessage": NUDGE_TEXT}}]},
                ensure_ascii=False,
            )
        )
    except Exception:
        print("{}")


if __name__ == "__main__":
    main()